
Vi har vænnet os til udtrykket ‘kunstig intelligens’, som i dag særligt sidestilles med sprogmodeller såsom ChatGPT, Gemini og Claude. Men lever den nye teknologi op til navnet?
Det er særligt deres udviklere – heriblandt direktørerne for virksomheder som OpenAI og Anthropic – som mener, at modellerne viser tegn på, at de er intelligente.
Når vi spørger forskerne, får vi dog et andet svar. Begrebet »intelligens« er nemlig ikke ligetil, og mens forskere kan være meget uenige om, hvad intelligens er, så er et flertal enige om, at sprogmodeller ikke er intelligente.
Det viser vores nye studie, som er lavet i samarbejde med kolleger fra IT-Universitetet og Københavns Universitet. Vi har spurgt over 300 forskere fra hele verden; både om hvad de mener intelligens er, og om de mener sprogmodeller lever op til dette.
Sprogmodeller består af funktioner
For at kunne tale om, hvorvidt en sprogmodel er intelligent, bliver vi nødt til at forstå, hvordan den virker.
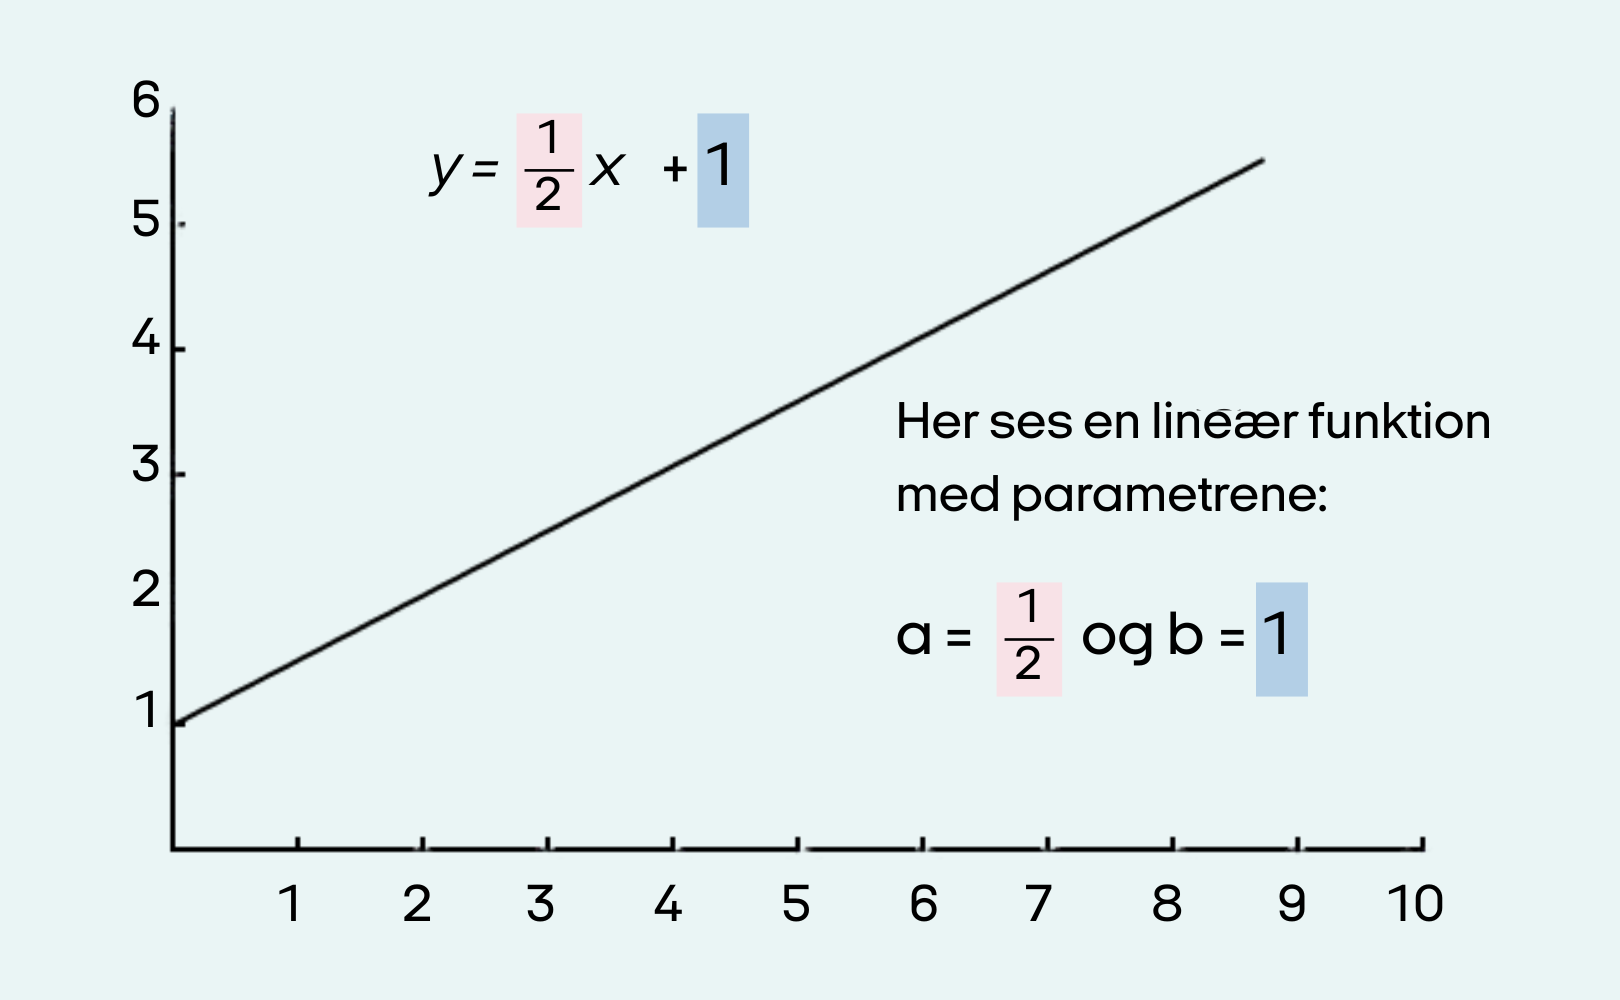
En sprogmodel er i bund og grund en stor, kompliceret matematisk funktion. Et eksempel på en meget simpel funktion er en lineær funktion, der kan skrives som y = ax + b.
I denne funktion bestemmer b hvor en linje skærer y-aksen i et koordinatsystem og a bestemmer hældningen på linjen. x er et tal som vi kan indsætte i funktionen, og så får vi et resultat, y, ud på den anden side.
Dette a og b er, hvad vi kalder funktionens parametre, og den lineære funktion har altså to parametre.
Det er disse parametre, der bestemmer, hvad vi får ud på den anden side, når vi kaster noget ind i funktionen. Hvis a har en højere værdi får man en stejlere linje, som illustreret i figuren nedenfor.
Princippet er helt det samme i ChatGPT. I en sprogmodel har vi bare at gøre med en sammensætning af funktioner, som gør at sprogmodeller ofte består af flere milliarder parametre. Man tager altså resultatet af mange komplekse funktioner og lægger dem sammen.
Det mest sandsynlige svar
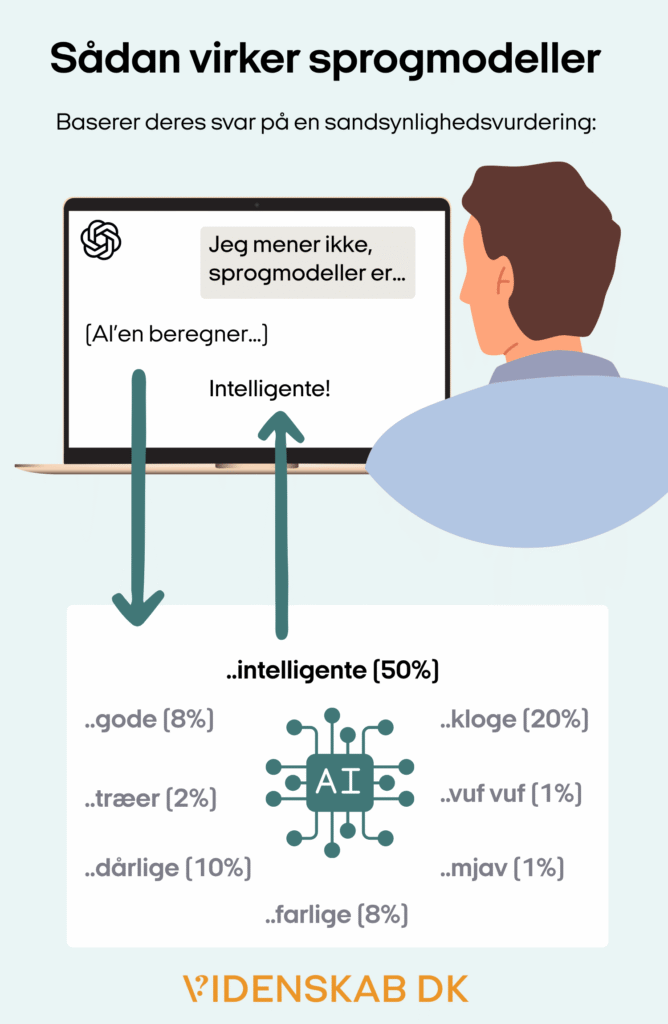
Når vi ‘træner’ en sprogmodel, indstilles alle parametre i modellen på en måde, så modellen bedst muligt kan forudsige det mest sandsynlige næste ord i en sætning på baggrund af det tekst-data, vi har valgt at træne den på.
Når du skriver noget til ChatGPT, udregner modellen en sandsynlighedsfordeling over ord, der kunne følge efter, og returnerer ordet med størst sandsynlighed (og så det næste ord og det næste ord osv.).
Det minder lidt om ‘autocomplete’ på din mobiltelefon. Når du begynder at formulere en sætning som ‘Har du planer…’, dukker der forslag op, som er sandsynlige fortsættelser af det, du er i gang med at skrive, såsom ‘... i aften’, ‘... i sommerferien’ eller ‘... lige nu’.
Der er selvfølgelig mange detaljer og nuancer i dette, men det er grundlæggende, hvad der sker i ChatGPT.
Det store spørgsmål er altså, om denne myriade af matematiske variable tilsammen udgør noget, vi kan kalde ‘intelligens’?
Hvad mener forskerne?
Vores studie viser, at størstedelen af de adspurgte forskere (71 procent) ikke anser sprogmodeller for at være intelligente.
Man kunne måske forestille sig, at forskere fra forskellige felter ville have forskellige meninger om, hvad intelligens er.
Men i undersøgelsen fandt vi ingen substantiel forskel i holdningerne blandt forskere fra forskellige fagområder (sprogteknologi, datalogi, lingvistik, neurovidenskab, psykologi, matematik, statskundskab, og flere).
Omkring 60 procent tror ikke engang, at sprogmodeller baseret på samme teknologi kan blive intelligente i fremtiden.
Uenighed om definitionen på intelligens
Der er hovedsageligt to ting, der ligger til grund for udviklernes og forskernes forskellige syn på, om sprogmodeller er »intelligente«.
Først og fremmest er der uenighed om definitionen af intelligens. At forklare, hvad man mener med ordet, må siges at være meget fundamentalt for at kunne vurdere, om en given ting (en sprogmodel, et dyr, et menneske) er intelligent.
For det andet er der uenighed om, hvad en sprogmodel egentlig kan. Nogle mener eksempelvis, at de blot er »papegøjer«, der gentager det data, de er trænet med.
Det kan nemlig være meget svært at vurdere, hvad ChatGPT har »lært«, når vi ikke ved hvilke data sprogmodellerne bag ChatGPT er trænet på, og vi heller ikke har adgang til modellernes parametre.
Netop derfor er en af de helt store uenigheder, hvorvidt ChatGPT bare gengiver tekst, den er blevet trænet på, eller om der sker noget ‘intelligent’ inde i funktionen, når man skriver med den.
OpenAI holder mange oplysninger hemmelige, og derfor er det svært for uvildige forskere at vurdere, hvordan ChatGPT når frem til sine svar.
Men ifølge OpenAI er GPT-5 et stort spring i intelligens i forhold til tidligere modeller, og firmaet hævder nu, at den eksempelvis ved, hvornår den skal »bruge længere tid på at tænke« over et problem.
Forskellige definitioner af intelligens
En kendt forsker i maskinlæring, Francois Chollet, definerer dét at være intelligent som evnen til hurtigt at lære nye ting.
Direktøren for OpenAI, Sam Altman, har udtalt, at AI må siges at være »super-intelligent«, hvis det kan udføre de fleste opgaver, som et menneske kan.
Men hvad kan forskere egentlig være enige om, når de snakker om intelligens i dag?
Vi undersøgte mere end 70 forskellige definitioner af ordet »intelligens« fra internationale forskere indenfor diverse felter såsom AI, datalogi, psykologi, filosofi og neurovidenskab.
Næsten alle forskerne mente, at evnen til at »ræsonnere« (83 procent), til at »generalisere« (86 procent) og til at »tilpasse sig« (83 procent) alle er fundamentale for at noget kan siges at være intelligent.
Endnu engang kunne vi se, at der var bred enighed på tværs af fag.
De tre begreber lægger sig tæt op ad hinanden, men man kan eksempelvis forstå »ræsonnement« som en skelnen mellem, hvorvidt en model rent faktisk udregner svaret på et spørgsmål eller om den blot har set svaret før.
Hvis du spørger ChatGPT: »Hvad er 17 + 25?« får du med stor sikkerhed at vide, at det er »42«. Men det skyldes højst sandsynligt, at netop det spørgsmål befinder sig i den tekst-data, modellen er trænet på. Det handler altså ikke om, at ChatGPT udfører hovedregning.
Fremtidens sprogmodeller
Forskningen viser, at sprogmodeller er gode til at gentage data og argumenter, de har set i deres træningsdata, men de er ikke gode til at løse opgaver, de ikke har set før.
Og hvis man blot gentager statistiske mønstre fra noget man er stødt på før, kan det næppe beskrives som ræsonnering eller generalisering.
Det betyder ikke, at ChatGPT, Gemini eller Claude ikke kan være brugbare værktøjer i nogle sammenhæng. Der er jo en grund til, at de er blevet så populære. Vi mener dog, at det er vigtigt at være opmærksom på sproget, vi benytter, når vi taler om sprogmodeller.
Når man vælger at beskrive et chat-system som intelligent, giver det flere underforståede betydninger. Vi begynder måske at tilskrive sprogmodellen en personlighed eller egne hensigter – og det er hverken korrekt eller hensigtsmæssigt.
En sprogmodel kan for eksempel ikke »lyve«, da den ikke har noget begreb om, hvad der er sandt eller falskt, men blot genererer nye ord baseret på sandsynligheder, der er afhængige af al den tekst, som modellen er blevet trænet på.
Om vi forstår modellerne som værende intelligente kan desuden have betydning for, hvordan vi vælger at bruge dem, hvor stor tillid vi har til dem, og hvem der står til ansvar for, hvad de genererer.
For nyligt har der for eksempel været sager, hvor forældre har sagsøgt udviklere af chat-systemer, fordi de angiveligt har været medvirkende årsag til selvskade og selvmord.
Vi mener, at sprogmodeller bør anses for, hvad de er: En meget kompliceret funktion, som er trænet på utrolige mængder tekst-data, og derfor er rigtig gode til at generere tekst som et menneske ville gøre det.
Uanset hvor god en sprogmodel er, så kan den ikke løse alle problemer, og specielt ikke problemer, den aldrig har set løsninger på før. Og netop det bør vi være opmærksomme på, før vi beder »AI« om at løse alverdens problemer.