


Da den danske Nobel-pristager Niels Kaj Jerne fyldte 60 for over 25 år siden, udgav det institut i Basel, som han havde grundlagt, og som han var direktør for, et festskrift, hvori det første indlæg var af mere filosofisk natur og skulle vise noget om den danske (læs: Niels Jernes) måde at forholde sig til videnskabelige problemer på.
Den gik på, at man havde bedt forskellige nationaliteter om at skrive en bog om kaninen. Den franske udgave blev ikke uventet kaldt 'Kaninens kærlighedsliv', den italienske 'Kanin på 100 måder', og den tyske 'En kort kaninhåndbog i fire bind'. Pointen var så, at den danske udgave på bedste Søren Kierkegaard maner hed 'Kaninen – eksisterer den?'
Der er både før og siden bygget flere nationaliteter på, og den amerikanske er så oftest 'Kaninen – hvordan man gør den større og hurtigere'. Denne devise gælder også for amerikanernes afkodning af vores genom. Der blev for 15 år siden postet enorme summer i det humane genom projekt, og dets succes er der ingen, som drager i tvivl.
Imidlertid viste det sig, at der var andre måder at foretage denne afkodning på end den dyre, og et privat firma viste sig faktisk – med meget færre midler – at være i stand til klare opgaven med en sådan hastighed, at offentliggørelsen af fundene kom samtidigt. Hvad mere er, resultaterne var stort set ens.
Sammenligningen er, at læse det første bogstav på hver side i en bog
Så langt, så godt. Prisen og tidsforbruget på at afkode et menneskes genom er gået drastisk ned samtidig med, at der er kommet mange flere firmaer på banen, som tilbyder private at undersøge deres DNA. Nu er dette et vidt begreb. Mig bekendt tilbyder man – endnu – ikke den afkodning, som lige er beskrevet.
Det er det komplette genom, svarende til at man læser alle bogstaver i en bog på mange millioner ord. Det er heller ikke den afkodning, som kun omfatter et par procent af det komplette genom, men som koder for de allervigtigste dele af genomet (exomet).
Dette har vist sig at være en meget informativ måde at afkode på, selv om det typisk kun er 2%, der afkodes – svarende til at de væsentligste navneord i en bog aflæses. Nej, det som de fleste amerikanske firmaer tilbyder, er at afkode de bittesmå variationer, som sidde mange millioner af steder i vores arvemasse.
Det lyder ikke af meget, og det kan vel sammenlignes med, at man kan læse det første bogstav på hver side af en bog. Baggrunden for overhovedet at gøre det er imidlertid teoretisk set god nok: det har nemlig vist sig, at disse ændringer (kaldet SNPs og udtalt snips) kan betyde meget for udvikling af sygdom.
Inden for mit eget felt for eksempel, om man afstøder blodstamceller fra en bror eller søster. Baggrunden er, at udskiftning af én byggesten kan ændre hele bygningens struktur (eller for at blive i bog analogien, at 'Kat' kan blive til fx 'Hat').
Prøvesvarene var ofte forskellige og modstridende
Så i teorien skulle grundlaget for de private firmaer være i orden, og de har da også fungeret i USA i nogle år. Ud fra en artikel i den anerkendte avis The New York Times den 31. december 2013 kan man desværre komme endog meget i tvivl om relevansen af deres svar.
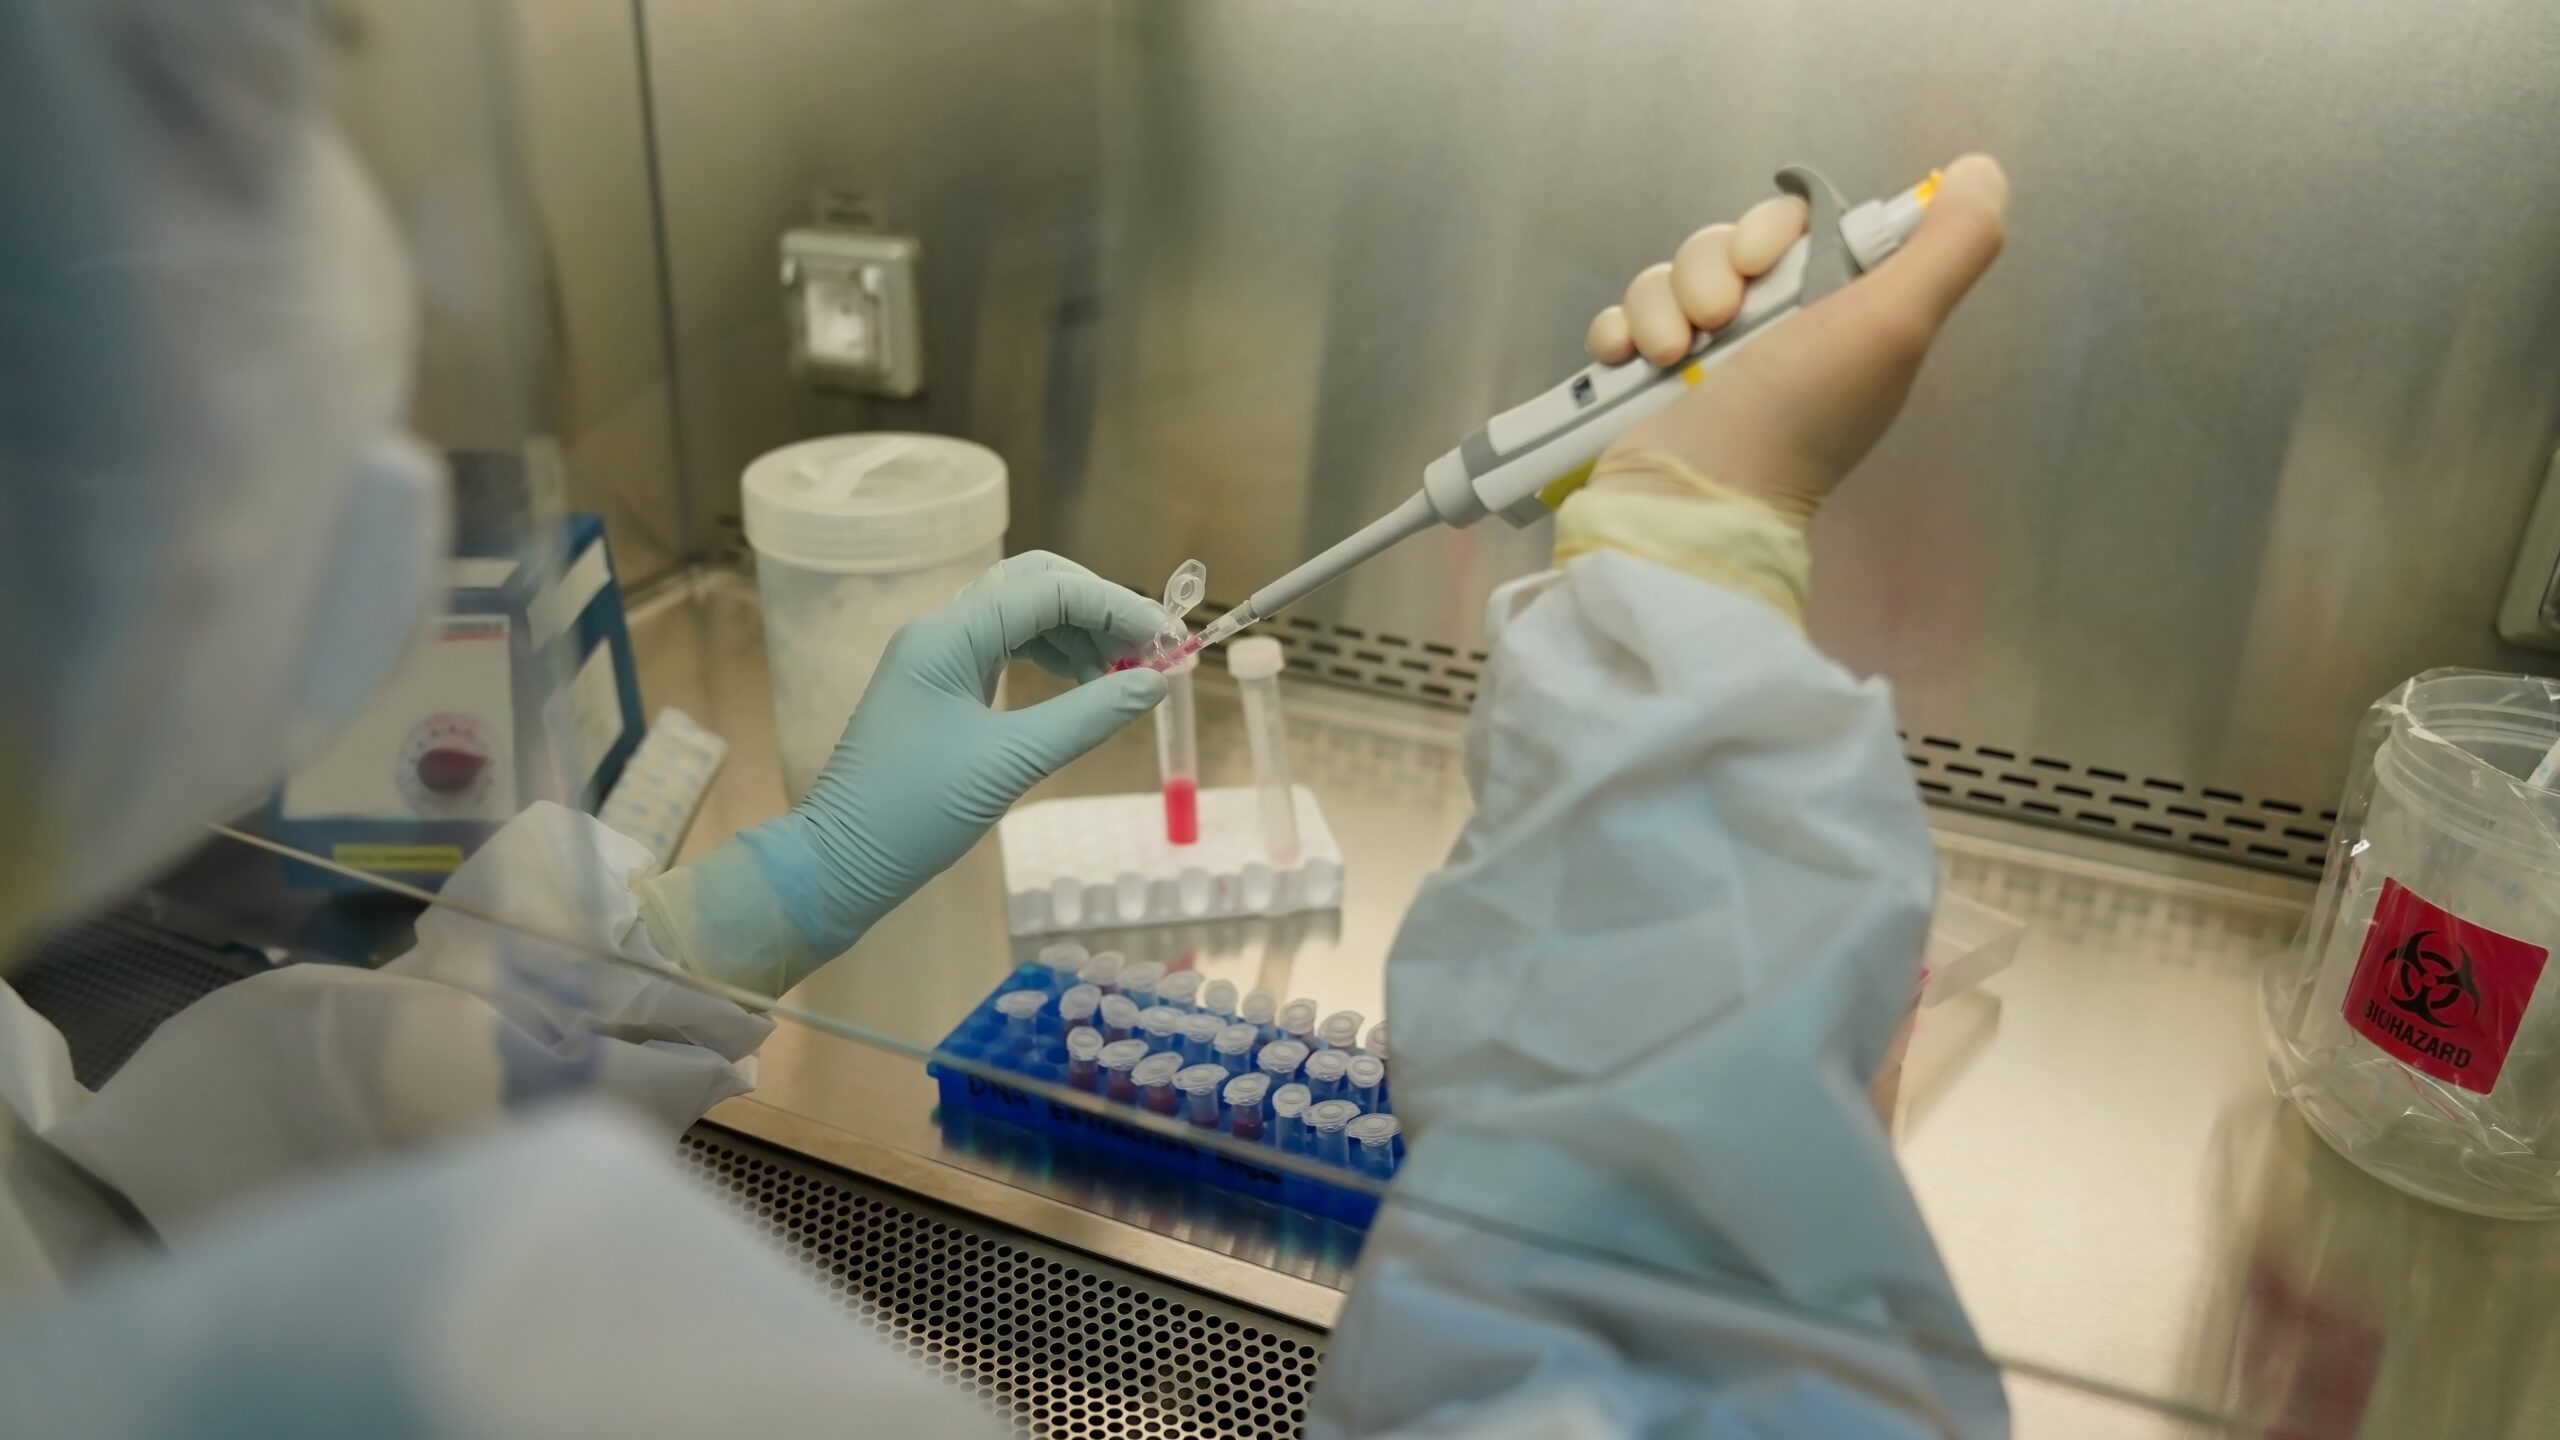
En (rask) 28-årig journalist (i gang med en kandidatuddannelse i bioetik) sendte sit spyt (det er faktisk nok) til tre forskellige firmaer i håb om at få viden om hendes risiko for udvikling af de mest kendte sygdomme, fx arteriosklerose, diabetes, gigtsygdomme og Alzheimer.
Det forlyder ikke ud fra artiklen, om firmaerne anvendte de samme maskiner og computerprogrammer, men det kunne se ud som de ofte læser SNPs på forskellige steder i genomet. I alle tilfælde var svarene på risikoen for sygdomsudvikling forskellige og ofte indbyrdes modstridende (fx vedrørende udvikling af psoriasis), og det finder jeg skræmmende.
For journalisten, som skriver, at både arteriosklerose og brystkræft forekommer i hendes familie, må et have været en ubehagelig oplevelse.
Hardwaren er langt foran os
Udover de forskellige steder, der læses og det, at der måske ikke er anvendt samme apparatur, kan jeg se i hvert fald ét problem mere ved denne selvbestaltede undersøgelse. Det drejer sig om fortolkningen af de store, store mængder data, som en lille spytklat altså kan afstedkomme.
Der er øjensynligt ikke fastslåede rutiner for at se på data, herunder at bedømme om de giver en højere risiko. Dette har også relevans for andre afkodninger, og her kommer så min pointe. Det, som mangler i mange situationer, er ekspertise i bioinformatik, frit oversat læren om, hvordan man får store datasæt kogt ned til brugbare udsagn.
Det virker, som om hardwaren er langt foran os, som skal få data fra dem til at give mening over for patienter og til sin tid måske også ikke syge, som ønsker det samme om journalisten. Det er uden tvivl en læringsproces for os alle, men det ville unægteligt være rart, om vi havde nogle lærere, dvs. bioinformatikere.
Der er p.t. ikke nogen uddannelse i dette felt, og det samme gælder, sådan som jeg orienteret, Tyskland, England og USA, hvor min forskergruppe har samarbejder, og hvor jeg har været på besøg og talt indgående med kolleger om det. Jeg har hørt en bioinformatiker beskrevet som en person, som går i sandaler og Bermuda shorts fra marts til november. Den definition er ikke meget informativ.
En engelsk kollega kom det måske lidt (men også kun lidt) nærmere ved at sige, at en bioinformatiker er en person, man søger hjælp os, men hvor standard svaret er: »Fortæl mig, hvad du leder efter, og jeg skal finde det!«
De amerikanske tilstande kommer snart til Europa
I Århus arbejder vi på sagen ved at fokusere på bioinformatik på den relativt nye molekylær medicin uddannelse, og i mit center på Universitetshospitalet forsøger jeg at få oprettet en enhed, som kan rådgive - måske endda uddanne - ph.d. studerende til bedre at forholde sig til de store datamængder, som vi i stigende grad skal tage stilling til i den kliniske situation.
For én ting er sikkert: de amerikanske tilstande kommer snart til Europa. Forhåbentlig ikke som de private firmaer, som jeg har omtalt, men ved gennemprøvede metoder, som ikke alene diagnosticerer kendte forandringer, som giver højere sygdomsrisiko, men også opdager nye.
Så summa summarum: jeg ved ikke, om kaninen eksisterer, men det kommer udvidede gentests til, og vi må være klar til at forholde os til dem.
Denne artikel er oprindeligt publiceret som et blogindlæg.