
Som statistiker møder jeg ofte respekt, når jeg taler med andre - men sjældent nysgerrighed.
Måske tænker de, at det jo er noget frygteligt kompliceret noget med tal og optællinger. Det skal de ikke selv nyde noget af.
Nu, jeg overvejer det, er det måske ikke kun respekt, men også en form for fremmedgørelse, jeg møder.
Berøringsangsten for tal giver data og statistikere en vis mystik, måske endda autoritet. Samtidig bliver det en undskyldning for at holde sig fra at tænke for meget over tal og data.
Desværre er det sjældent en god idé at lukke øjnene for noget, der både er vigtigt og brugbart.
I denne artikel giver jeg eksempler på, hvordan statistiske metoder og data faktisk kan sige noget meningsfuldt om hverdagen.
Måske kan det hjælpe til at tø lidt af den kolde skulder, som statistikkens fans ofte møder.
\ Book et gratis foredrag med en forsker
Christoffer Sejling, forfatteren til denne tekst, er med i 'Bestil en Forsker'-ordningen – en del af Forskningens Døgn – hvor forskere kan bookes gratis til at holde et foredrag i uge 17.
Christoffer Sejling stiller op med foredragene: ’Når statistikken kan finde den information, vi har mistet' og 'De rigtige vindere af Premier League'
Der er 292 gratis foredrag at vælge imellem om alt fra hvalstrandringer, udendørs leg, AI, Trump, fedme, universet, havvind, moralfilosofi og meget, meget mere.
Se de mange tilbud for de øvrige forskere i ordningen her.
Vigtige datoer: Forskerne kan bookes til og med 13. marts. Foredragene finder sted 20.-26. april.
Hvor mange skal vi invitere til barnedåben?
For et par måneder siden skulle min hustru og jeg arrangere vores datters barnedåb. Vi var dog ikke helt klar over, hvor mange vi ville invitere. Vi ville gerne ende på omkring 50 personer, men var nok nødt til at invitere lidt flere end det.
Her har store familiearrangementer og flyvninger dét til fælles, at man ofte får overbooket arrangementet. Men hvor meget kunne vi egentlig tillade os at overbooke for at ramme nogenlunde 50 gæster?
Efter at have modtaget alle tilbagemeldinger på i alt 70 invitationer, noterede jeg, hvor mange dage der var til SU-datoen, på tidspunktet hvor de forskellige personer svarede, om de ville deltage.
Jeg havde nemlig på forhånd en idé om, at jo tidligere man svarer på invitationen, des større er sandsynligheden for, at man gerne vil komme og rent faktisk kommer.
Jeg brugte en model, hvor jeg lod sandsynligheden for et positivt svar være afhængig af antal dage til SU.
Så kunne vi besvare spørgsmål som: Med 10 dage til SU og 26 personer der ikke har svaret på invitationen, hvad er da det forventede antal deltagere? Eller: Kan vi forvente, at vi bliver under 50 deltagere, da det er, hvad der er plads til i kirken?
Modellen giver os følgende billede, hvor vi som forventet ser en dalende tendens til positivt svar, når vi nærmer os datoen for SU:
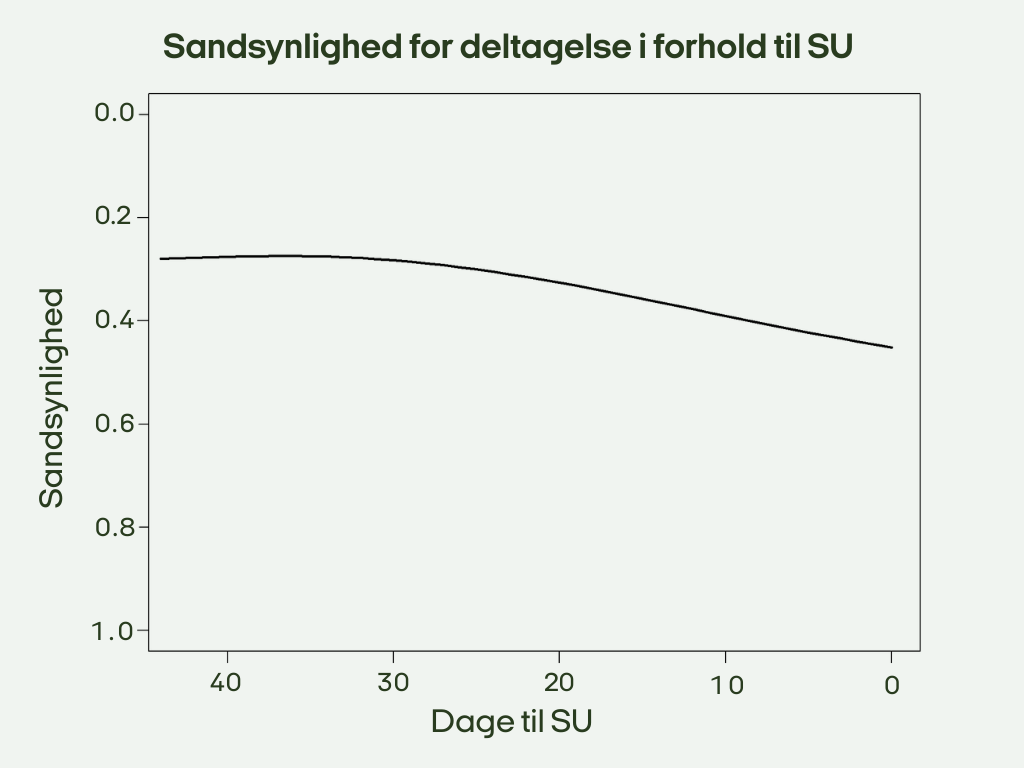
Vi kan læse ud af grafen, at hvis der er under 10 dage til SU, så er der omkring 60 procent sandsynlighed for et positivt svar.
Det vil sige, at står vi med 26 ubesvarede invitationer og 10 dage til SU, kan vi forvente omtrent 16 yderligere deltagere.
Lægger vi de 16 yderligere deltagere oveni de 42 deltagere, vi står med ved 10 dage til SU, ender vi så med et forventet antal deltagere på 58.
Altså ser det ud til, at de mindst religiøse gæster må springe kirken over eller stå udenfor og kigge ind ad vinduet.
Disse resultater fortæller os noget om, hvad vi vil kunne forvente for et tilsvarende arrangement. Holder vi igen en barnedåb for 70 inviterede gæster, der er ligesom dem, vi har inviteret her, har vi altså nogle helt konkrete tal på, hvordan vi kan forvente, at arrangementet kommer til at se ud.
Selvfølgelig kan vi aldrig lave helt samme situation to gange, men med denne barnedåb er vi i hvert fald endt et sted, der minder meget om, hvor vi endte med storebrors dåb.
\ Hvad kommer barnedåben til at koste?
Tænker vi på det økonomiske perspektiv, kan vi med en kuvertpris, som i dette tilfælde er 350 kroner, også estimere hvad udgiften til barnedåben bliver, inden vi faktisk står med regningen.
Vi ved selvfølgelig, hvor stor udgiften bliver for alle dem, der har tilmeldt sig: 10 dage før SU har 42 sagt ja til at deltage, og det giver en udgift på 14.700 kroner.
Men så havde vi jo også det her spørgsmål om de 26 ubesvarede invitationer. Hvilken restudgift kan vi forvente, at det giver?
Vi udregnede før, at forventeligt vil 16 ud af 26 give et positivt svar på invitationen. Det giver en udgift på 5.600 kroner, som skal lægges oveni den eksisterende udgift på 14.700 kroner.
Men vi kan jo stadig risikere, at én bliver syg, eller flere vil sige ja, selvom de først svarer lige inden SU. Derfor er det rart at arbejde med en buffer eller et ’sikkerhedsinterval’, som det hedder på statistik-sprog.
Lige netop sikkerhedsintervaller og variation er helt centrale begreber for den statistiske metode. Det er ikke nok at komme med et bud, et såkaldt 'estimat'. Vi bliver nødt til at sige noget om usikkerheden, altså kvaliteten, på det bud.
Hvilke andre værdier er også i overensstemmelse med den data, vi har? Et Sikkerhedsinterval indeholder netop de værdier, som, vi ikke vil udelukke, kan være den sande værdi for det tal, vi søger.
Vi kan regne os frem til, at den forventede ekstraudgift (eller ’sikkerhedsintervallet’) ligger på 3.505 kroner til 6.772 kroner.
Det betyder, at alle værdier mellem 3.505 og 6.772 er rimelige som gennemsnit for ekstraudgifter, hvis vi skulle forestille os at lave ’eksperimentet’, hvor vi står med 10 dage til SU og 26 ubesvarede invitationer mange gange.
Når vi ser på et konkret datasæt, kommer der dog ekstra usikkerhed fra stikprøvevariation (sample variation). Tager vi også den med, får vi et bredere interval på 2.800 til 8.050 kroner for den faktiske restudgift.
På den måde er anerkendelsen og beskrivelsen af den statistiske usikkerhed det værktøj, som giver os et både mere nuanceret og mere retvisende billede af virkeligheden.
Hvor mange dage er der, til vi skal have take-away igen?
Det er udmattende at lave mad hver eneste dag. Først skal man tænke over, hvad der skal laves. Så skal der faktisk købes ind. Dertil kommer selve tilberedningen. Til sidst er der opvasken. Efter få dage i den rytme kommer tanken snigende: Hvornår skal vi have take-away?
I min hverdag er take-away sådan en gentagende proces. Det er ikke sjældent, at jeg nærmest tæller ned til næste gang vi skal have mad udefra, uden helt at vide hvornår det bliver.
Heldigvis kan statistikken fortælle mig lidt om det. Det kunne da være fedt at vide, hvad sandsynligheden er for at få take-away i morgen, givet at det er en uge siden vi sidst fik det.
Når vi vil bruge statistiske metoder, er det ofte, fordi vi har data til rådighed. Jeg har her samlet et datasæt med målinger af, hvor mange dage der er gået mellem bestillinger af take-away. Det kunne meget vel være et datasæt fra min egen hverdag.
\ Klar til mere statistik?
Er du blevet nysgerrig på, hvad statistik egentlig kan bruges til — og klar til næste skridt?
Så tag et kig forbi statistik-professor Claus Thorn Ekstrøms blog 'Sandsynligvis.dk'
Her finder du masser af artikler, forklaringer og eksempler, der gør statistik mere håndgribelig — lige fra hverdagssituationer til mere avancerede problemstillinger. Du kan også lære om 'r-project.org' — det statistikprogram, jeg har brugt til at lave beregningerne i denne artikel.
Dette data indeholder ’overlevelsestider’ for 100 bestillinger, hvor ’død’ forbindes med at en bestilling finder sted, og overlevelsestiden er dagene indtil næste død/bestilling.
Når vi har med sådanne overlevelsestider at gøre, kan vi i statistikken definere en såkaldt ’hazard funktion’, der giver os den øjeblikkelige risiko/chance for at noget bestemt sker (vi bestiller take-away), givet at det ikke allerede er sket (siden sidste gang).
Når vi står på tærsklen til den fjerde dag efter seneste bestilling af take-away, indeholder hazard-funktionen altså information om, hvad sandsynligheden er for at få take-away på den fjerde dag, givet at det ikke er sket de første tre dage. Vi kan estimere denne funktion ud fra data på de 100 bestillinger.
Fordelingen af data ser ud som forneden. Her betegner søjlerne, hvor mange af bestillingerne der er sket et bestemt antal dage efter seneste bestilling. Der går altså mellem 4 og 12 dage fra den ene bestilling til den næste.
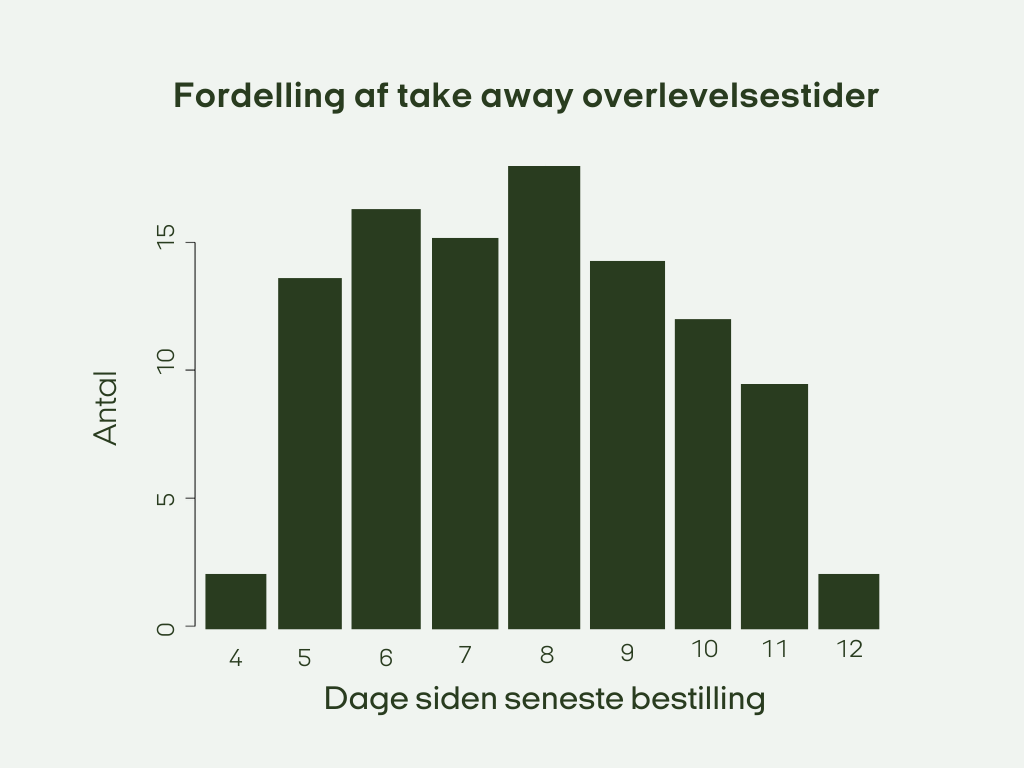
Har jeg netop fået take-away, vil mit bedste bud på, hvornår det sker igen, være om cirka 8 dage, da det er her, søjlen er højest, men med hazard-funktionen kan vi også sige noget om, hvordan sandsynligheden udvikler sig, som tiden går.
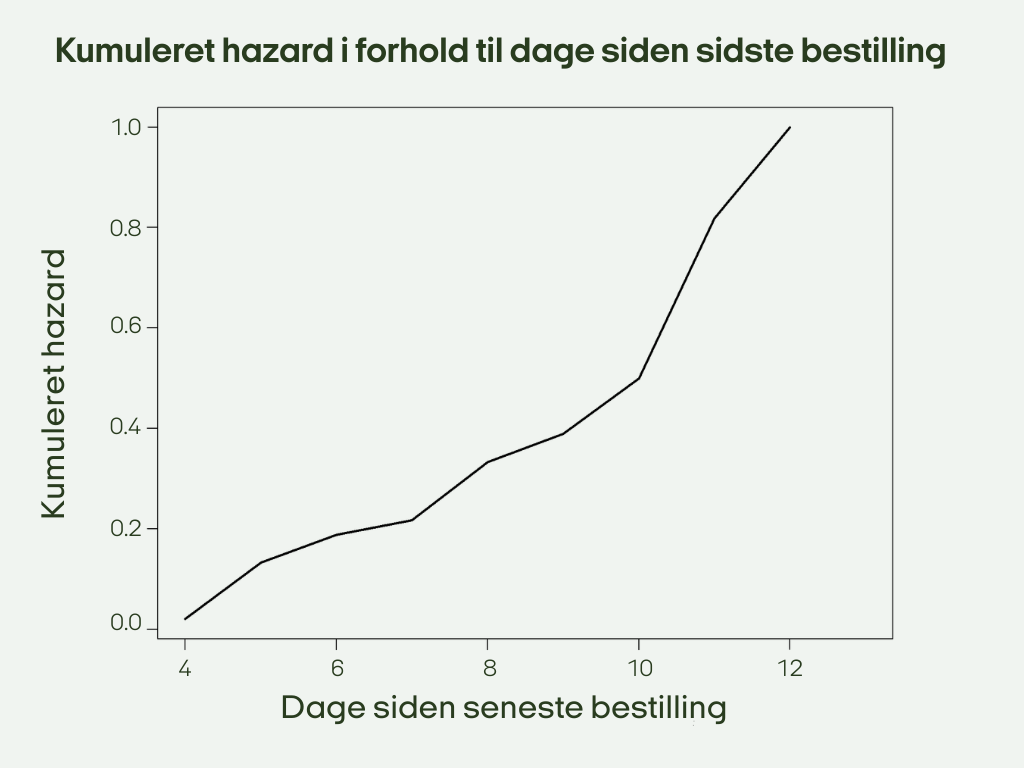
Herunder har vi estimeret hazard-funktionen og lagt sammen dag for dag. Vi ser, at hazarden, som er forskellen fra én dag til den næste, bliver større og større.
Altså, bliver der en større og større tendens til at bestille take-away, desto længere pausen siden seneste bestilling bliver. Jeg ved ikke med dig, men det stemmer rigtig godt overens med min egen oplevelse.
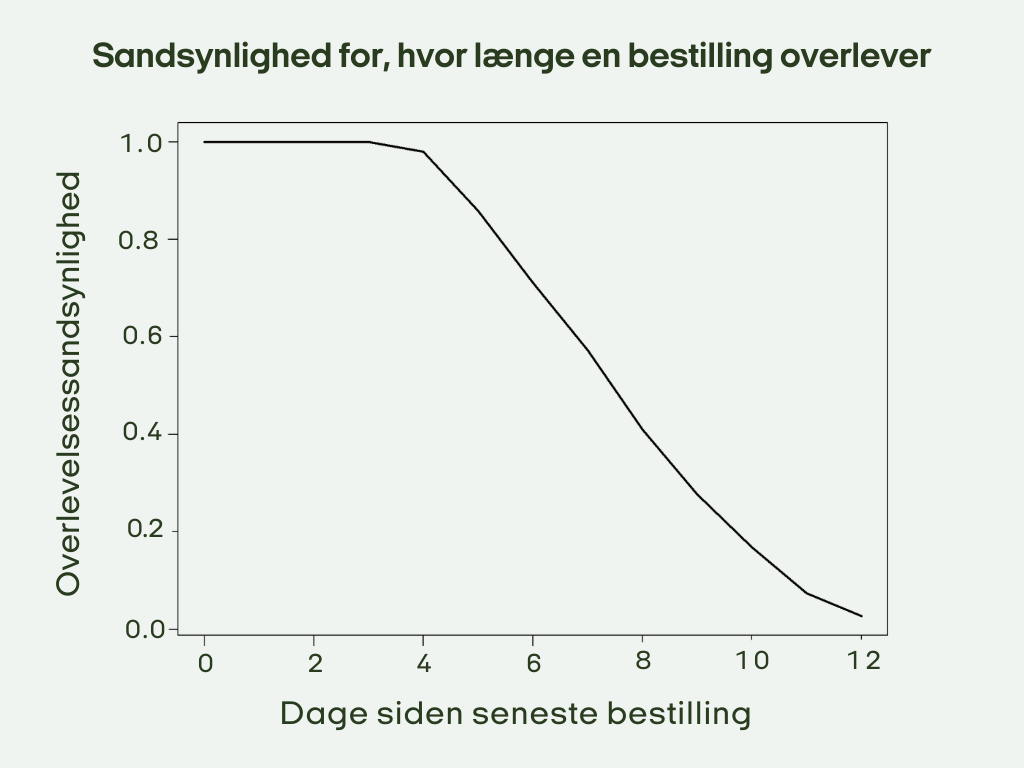
Til sidst er det muligt at oversætte hazarden til en 'overlevelsesfunktion', altså, hvor mange dage overlever en bestilling, før den bliver lavet?
Her kan vi for eksempel aflæse, hvad sandsynligheden er for, at der går mindst 7 dage mellem to bestillinger af take-away (at en bestilling ’overlever’ i syv dage eller mere).
Der ser vi blot på, hvad der står på y-aksen ud fra 7 på x-aksen på grafen herunder. Altså er der cirka 0.5 (50 procent) sandsynlighed for, at der går mindst 7 dage mellem to bestillinger. Hvis det ikke er vigtig hverdagsviden, ved jeg ikke hvad er.

Skal det absolut være min skyld, at jeg er blandt de dårligste?
Til sidst flytter vi fokus en smule fra hverdagen og ind i forskningen. Når vi undersøger befolkningen, hvad enten det gælder unges mentale sundhed eller folkeskolernes karaktergennemsnit, er der altid et fokus på dem, der ligger i den tunge ende af spektret.
De 20 procent af skoler med de laveste snit skal gøre det bedre, og de 10 procent unge, som har de værste sundhedscorer, skal rykkes mod 'normalområdet'.
De ønsker bygger især på to ting: Der er en årsag til, at de, der ligger lavt, ligger, hvor de gør, og den årsag kan have negative konsekvenser.
Dette er dog noget, man kan udfordre. For er vi egentlig sikre på, at det billede, vi ser, skyldes et reelt problem, som har en årsag, eller er det bare tilfældighed?
Nogen skal jo udgøre de ’værste’ 10-20 procent, uanset hvor ’godt’ det står til samlet, og vi kan ikke udelukke, at det til tider er ren tilfældighed, at nogle slår ud som de værste eller bedste.
\ Tænk på en håndfuld tegnestifter
For at forstå, hvad jeg mener med tilfældighed, laver vi et fiktivt eksempel med en graf over karaktergennemsnit for en dansk folkeskole.
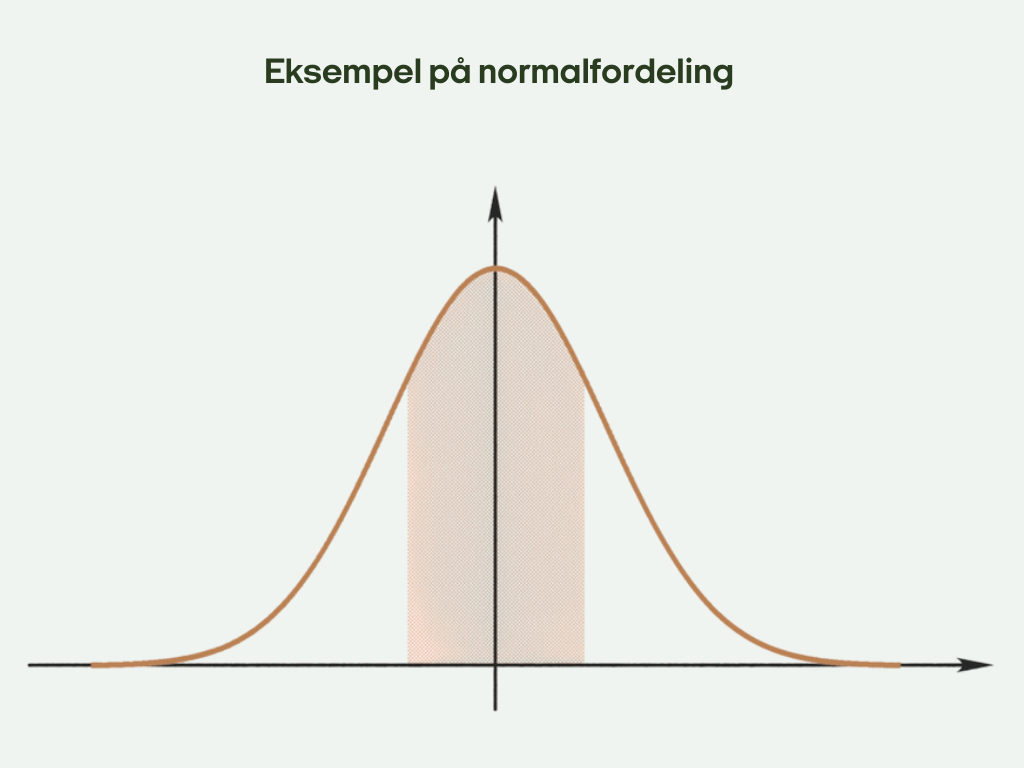
Hvis vi forestiller os, at alle elevernes karaktergennemsnit kommer fra den samme underliggende normalfordeling - altså, at alle unge for eksempel er lige dygtige, men at der er nogle tilfældige ting, som gør, at ikke alle svarer ens på en prøve - så vil resultaterne fordele sig cirka som på nedenstående figur.
Mange vil ligge tæt på gennemsnittet (den stiplede lodrette linje), men nogle vil komme til at ligge i ekstremerne (højre og venstre side).
Forestil dig, at man slipper en håndfuld tegnestifter på gulvet: Nogle vil rent tilfældigt lande langt fra de andre, selvom de alle har samme udgangspunkt.
På samme måde kan skoler det ene år have lavere karakterer, mens de det næste år har et højere karakterniveau.
Man kan forestille sig, at skolen har et underliggende niveau, og at hvert års karaktergennemsnit fremkommer som dette grundlæggende niveau plus noget tilfældighed, i form af hvilke elever der går på skolen dét år, hvordan eksamen har set ud, eller om der har været ændringer i pensum.
Det er så en tilfældighed, der kan gå i begge retninger.
Når vi ser sådan en graf, kan vi altså ikke som udgangspunkt konkludere, at de, der ligger i bunden eller toppen, gør det, fordi de har nogle særligt dårlige eller gode egenskaber.
Det kan ske helt tilfældigt. Det er selvfølgelig ikke sådan, at de variationer vi ser i data altid skyldes tilfældighed, men det er vigtigt at være opmærksom på, at det er en mulighed.
Der skal noget argumentation til, før en graf som den herover skal få os til at sætte omfangsrige initiativer i gang, der skal skabe forbedringer.
Tilfældighed bør give anledning til omtanke. Data er ikke absolut. Der er ikke nødvendigvis én sandhed bag de tal, vi ser.
Vi er nødt til at se på alle de rimelige eller sandsynlige forklaringer, der er på, hvad vi har set.
Først da kan vi begynde at tale om, hvilken forklaring der er bedst eller mest sandsynlig. Dermed forstår vi bedre den virkelighed, vi agerer ud fra.
Din ven, statistikken
Hvis man er villig til at se sin hverdag i tal, får man en allieret i den statistiske tankegang. En model kan hjælpe os til at skabe realistiske forventninger for fremtiden.
Det sidste eksempel viser os også, at vi ikke kan overkomme eller ignorere tilfældigheder fuldstændigt. Hvis vi gør det, kan vi komme til at tro for meget på forklaringer af fænomener, der i virkeligheden er tilfældige.
Vi slipper ikke for tal, særligt ikke, når vi skal undersøge befolkningen og forsøge at skabe et bedre samfund.
Og når nu de er der, tallene, kan vi lige så godt gøre vores bedste for at forstå dem og bruge dem.